Buenas, esto es BIMPRAXIS, el podcast donde el
Download transcript (.srt)
0:09
0:15
0:20
0:23
0:26
0:28
0:36
0:40
0:42
0:45
0:46
0:47
0:48
0:52
0:55
0:58
1:01
1:05
1:06
1:10
1:13
1:16
1:17
1:18
1:20
1:21
1:24
1:25
1:28
1:32
1:35
1:37
1:38
1:41
1:42
1:43
1:47
1:50
1:52
1:56
1:58
1:59
2:02
2:04
2:07
2:10
2:12
2:14
2:15
2:17
2:19
2:22
2:23
2:25
2:27
2:30
2:34
2:37
2:40
2:43
2:46
2:48
2:52
2:55
2:56
2:58
3:00
3:01
3:02
3:04
3:05
3:06
3:10
3:11
3:13
3:15
3:18
3:20
3:21
3:24
3:25
3:27
3:28
3:31
3:33
3:34
3:36
3:36
3:38
3:39
3:41
3:44
3:45
3:48
3:51
3:52
3:54
3:56
3:59
4:00
4:01
4:03
4:05
4:07
4:08
4:12
4:14
4:16
4:17
4:19
4:22
4:25
4:27
4:30
4:31
4:33
4:35
4:36
4:37
4:37
4:40
4:41
4:45
4:46
4:47
4:47
4:51
4:54
4:55
4:57
4:59
5:02
5:03
5:06
5:07
5:08
5:10
5:12
5:14
5:16
5:17
5:19
5:21
5:23
5:25
5:25
5:28
5:32
5:33
5:34
5:37
5:40
5:41
5:44
5:47
5:47
5:51
5:52
5:56
5:57
6:00
6:01
6:01
6:04
6:04
6:07
6:10
6:11
6:14
6:16
6:19
6:21
6:24
6:27
6:30
6:31
6:32
6:36
6:38
6:41
6:44
6:44
6:45
6:46
6:46
6:50
6:52
6:54
6:56
6:59
7:01
7:04
7:06
7:10
7:10
7:13
7:16
7:16
7:19
7:20
7:22
7:26
7:28
7:32
7:34
7:36
7:39
7:40
7:44
7:46
7:48
7:50
7:51
7:54
7:57
7:59
8:02
8:03
8:05
8:06
8:08
8:11
8:11
8:14
8:18
8:20
8:20
8:22
8:25
8:27
8:30
8:32
8:32
8:35
8:37
8:38
8:41
8:43
8:44
8:46
8:48
8:50
8:51
8:54
8:55
8:56
8:58
9:01
9:03
9:06
9:08
9:10
9:12
9:13
9:14
9:19
9:21
9:24
9:27
9:28
9:30
9:31
9:34
9:38
9:40
9:40
9:42
9:44
9:46
9:50
9:52
9:56
9:58
10:01
10:04
10:06
10:07
10:09
10:10
10:12
10:16
10:20
10:22
10:25
10:27
10:28
10:29
10:31
10:32
10:34
10:35
10:37
10:39
10:40
10:41
10:43
10:46
10:48
10:49
10:50
10:52
10:54
10:56
10:57
11:00
11:01
11:02
11:05
11:07
11:08
11:10
11:13
11:16
11:16
11:17
11:19
11:22
11:25
11:26
11:28
11:31
11:33
11:34
11:36
11:37
11:39
11:40
11:42
11:43
11:45
11:47
11:48
11:50
11:51
11:53
11:54
11:55
11:59
12:01
12:04
12:07
12:09
12:11
12:14
12:16
12:17
12:21
12:23
12:26
12:28
12:30
12:31
12:33
12:34
12:36
12:37
12:40
12:44
12:44
12:46
12:48
12:51
12:52
12:53
12:56
12:59
13:01
13:03
13:05
13:06
13:06
13:08
13:11
13:13
13:14
13:15
13:16
13:17
13:18
13:22
13:25
13:25
13:28
13:28
13:30
13:33
13:35
13:35
13:38
13:41
13:45
13:48
13:51
13:52
13:55
13:56
13:58
14:01
14:01
14:04
14:05
14:07
14:08
14:11
14:13
14:14
14:16
14:17
14:20
14:23
14:24
14:25
14:27
14:30
14:33
14:35
14:39
14:41
14:42
14:44
14:47
14:49
14:51
14:53
14:55
14:58
15:00
15:02
15:02
15:05
15:09
15:10
15:11
15:12
15:14
15:16
15:18
15:21
15:23
15:25
15:25
15:30
15:31
15:34
15:38
15:40
15:41
15:45
15:46
15:48
15:49
15:52
15:54
15:57
16:00
16:02
16:05
16:17
16:19
16:21
16:31
16:35
BIM se encuentra con la inteligencia artificial.
Exploramos la ciencia, la tecnología y el futuro
desde el enfoque de la arquitectura, ingeniería y
construcción.
¡Empezamos!
Muy buenas, bienvenidas, bienvenidos a un nuevo episodio
de BIMPRAXIS.
Hoy os traemos la revolución de la IA
de bolsillo.
¿Estáis listos?
Pues entramos en materia.
A ver, imaginemos por un instante la infraestructura
física que impulsa hoy en día a las
inteligencias artificiales más avanzadas del panorama.
Claro, la imagen mental nos lleva directamente a
naves industriales, naves que ocupan hectáreas enteras.
Totalmente.
Decenas de miles de tarjetas gráficas gigantes apiladas
en servidores, con unos sistemas de refrigeración que,
bueno, exigen un consumo energético comparable al de
una ciudad pequeña.
Eso es.
Ese es el paradigma establecido en el sector
ahora mismo.
La inteligencia artificial de vanguardia es un coloso
inamovible.
Es extremadamente caro y, por pura definición, un
privilegio exclusivo de un puñado de megacorporaciones.
Exacto, pero revisando las fuentes y los datos
técnicos de hoy, nos encontramos con una anomalía
brutal.
Una anomalía que desafía toda la física y
la economía de este sector.
Sí, sí.
Un dispositivo capaz de ejecutar modelos masivos, ojo.
De hasta 120 .000 millones de parámetros.
120 .000 millones.
Y atención al dato, pesando apenas 305 gramos
y operando totalmente desenchufado de la nube.
Es una locura.
El contraste con la narrativa dominante de la
industria es abismal.
Mientras todo el mercado avanza hacia el gigantismo
de los centros de datos, hoy analizamos el
Tiny AI Pocket Lab.
Que de bolsillo tiene el nombre, pero de
potencia va sobrado.
A ver, vamos a desgranar esto, porque las
cifras… Las cifras resultan casi inverosímiles.
Hasta que analizas la ingeniería que hay detrás,
claro.
Físicamente, es un bloque con el tamaño de
una batería externa convencional.
Y como decías, ostenta el récord Guinness al
superordenador de inteligencia artificial más pequeño del mundo.
Fíjate, 305 gramos.
Para poner una referencia super cotidiana, un iPhone
moderno, si le pones una funda protectora normalita,
ya te ronda los 230 gramos.
Exacto.
Es que, por una fracción mínima de peso
adicional, este aparato promete democratizar modelos de lenguaje
gigantes.
Y para que esa promesa no se quede
en puro marketing, la clave tiene que estar
en el interior, ¿no?
Justo.
Porque esto no es un disco duro externo
glorificado.
Ni mucho menos.
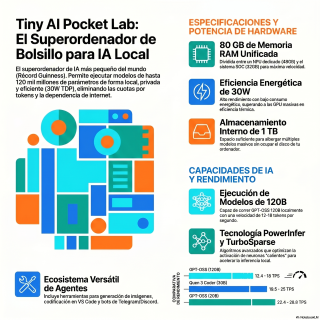
Este dispositivo viene equipado con 80 GB de
memoria unificada.
80 GB unificados, que se dice pronto.
Es una barbaridad.
En un ordenador tradicional… Sabes que el procesador
central y la tarjeta gráfica tienen sus memorias
separadas.
Pierden un tiempo y una energía inmensos copiando
datos de un lado a otro.
¿Yendo y viniendo constantemente?
Eso es.
La memoria unificada crea una especie de piscina
común a la que todos los componentes acceden
al instante.
Se acabó el cuello de botella.
Claro.
Y a eso le sumamos la unidad de
almacenamiento.
Sí, un SSD de un terabyte de capacidad.
A ver, que suena a jerga impenetrable, pero
el impacto aquí es vital.
Básicamente, no es solo un almacén enorme… Es
una autopista de altísima velocidad.
Exactamente.
Permite leer y escribir gigabytes de información por
segundo sin atascos.
Porque, claro, sin esa autopista, cargar un modelo
tan bestia sería eterno.
Vale.
Pero aquí es donde se me plantea un
reto analítico clarísimo.
Planteemos un escenario de la vida real basado
en las fuentes.
Tú coges este pequeño bloque y lo enchufas
por cable USB -C a tu portátil básico.
Un portátil cualquiera, ¿sí?
Imagínate un MacBook Air de entrada y entrada.
De estos que no tienen ni ventiladores, con
apenas 8 o 16 gigas de RAM.
Si el modelo de IA pesa una tonelada
y el portátil va justito, ¿cómo evita el
colapso absoluto al gestionar esa carga por un
simple puerto USB?
Pues mira, el error de base en ese
planteamiento es asumir que tu portátil está gestionando
el modelo.
Ah, no lo hace.
No, no.
El portátil no hace absolutamente nada a nivel
de procesamiento.
El Tiny Chronid actúa de forma completamente autónoma.
O sea que el portátil es solo la
pantalla.
Justo.
Ese disco SSD de 1 TB que mencionábamos
almacena los pesos del modelo, es decir, el
cerebro del sistema.
Y todo el cálculo ocurre dentro de los
procesadores del cacharro de bolsillo.
Entonces tu ordenador se queda como un terminal
ciego.
Un teclado y una pantalla para mandar instrucciones
y punto.
Eso es.
Así, el disco duro y la memoria de
tu portátil se mantienen intactos.
El espacio del usuario no se toca.
Vale, me resuelves el cuello de botella del
almacenamiento.
Así caben los datos.
Pero mover esos datos y procesarlos se exige
superar un límite mucho peor.
El límite térmico.
Claro.
Las tarjetas gráficas de escritorio que mueven estos
modelos consumen fácilmente entre 400 y 1000 vatios.
Son estufas.
Literales.
Pero este dispositivo, según las especificaciones, opera con
un TDP de tan solo 30 vatios.
30 vatios.
Se alimenta con un cargador de móvil normal.
¿Cómo no se derrite la carcasa al exigirle
cálculos?
Lo fascinante aquí es la división quirúrgica que
han hecho en la arquitectura interna.
El dispositivo alcanza un rendimiento total de 160
TOPS.
TOPS para clarificar trillones de operaciones por segundo,
¿verdad?
Exacto.
Es la métrica estándar para medir el músculo
en IA.
Pues bien, para lograr esos 160 TOPS sin
disparar el consumo eléctrico, no usan un procesador
generalista.
Lo dividen en dos cerebros especializados.
¿Y cómo se reparten la carga?
El componente principal es una NPU, una unidad
neuronal dedicada solo a IA.
Esta NPU acapara 48 GB de esa memoria
RAM unificada, con un ancho de banda altísimo,
y está enfocada en cálculos de formato FP16
e INT8.
Vale.
Detengámonos en esos formatos, FP16 e INT8, porque
requieren traducción para entender su impacto.
O sea, una red neuronal hace miles de
millones de multiplicaciones para adivinar la siguiente palabra,
¿no?
Sí.
Matemáticas, puras ideas.
Y duras.
Y, tradicionalmente, esas matemáticas usan números decimales larguísimos,
de alta precisión.
Ocupan mucho y gastan muchísima energía.
Una locura de energía, sí.
Pues lo que permiten esos formatos, FP16 e
INT8, es comprimir.
En lugar de 10 decimales, redondea y usa
números enteros más cortos.
Pierde una precisión microscópica, pero… Pero a cambio
es rapidísimo.
Es como pagar en efectivo y redondear los
céntimos, en lugar de hacer transferencias exactas por
cada centímetro.
El proceso huella, y el resultado es funcionalmente
idéntico.
Exactamente esa es la idea.
Y luego, complementando a la NPU, el dispositivo
lleva un SOC, un sistema en chip secundario,
que administra los 32 gigas de RAM restantes
y aporta a otros 30 TEOPS.
Esa es la base de hardware.
Pero las fuentes nos dicen que el hierro
es solo la mitad del cuento.
La verdadera magia, la brujería técnica que hace
que esto consuma tan poco, es la verdad.
Es el software de código abierto.
PowerInfer y TurboSparse.
Justo.
A ver, para explicar cómo sincronizan la NPU
con el SOC, introducen el concepto de la
localidad de activación.
Mantener neuronas calientes frente a neuronas frías.
Es un concepto clave, sí.
Se me ocurre una analogía con la alta
cocina.
Imagina que el modelo de 120 .000 millones
de parámetros es la despensa de un restaurante
gigante.
En cualquier charla con la IA hay conocimientos
básicos, lógica o gramática que se usan siempre.
Esas serían las neuronas calientes.
Exacto.
Son los ingredientes críticos.
La sal, el aceite, los cuchillos.
Todo eso lo pones directamente en la encimera
principal del chef, que sería la NPU, súper
rápida y siempre lista.
Totalmente.
En cambio, las neuronas frías serían las especias
raras que usas una vez al mes para
un plato exótico.
Esas las guardas en la despensa del fondo,
que sería el SOC o la CPU.
Fíjate que la analogía es perfecta.
Y Power Infer es el chef que orquesta
todo esto.
Optimiza la velocidad de forma brutal sin colapsar
el sistema.
Porque el sistema no pierde energía yendo y
viniendo a la despensa del fondo a cada
segundo.
Claro, mantiene lo crítico a mano.
Y el por qué importa esto es brutal.
Importa porque es lo que permite llevar computación
de altísimo rendimiento a un enchufe estándar o
a una batería portátil en una cafetería.
Se acabaron los costes recurrentes.
Eliminas el pago por tokens en la nube
por completo.
Y te garantiza una privacidad.
Tu datos, tu código, tus documentos no salen
de ese aparatito de 300 gramos.
Pero a ver, de nada sirve una arquitectura
innovadora si te exige un doctorado para poder
usarla.
Pasemos de los chips a la experiencia de
usuario.
Porque yo me esperaba la típica pantalla de
terminal negra con letras verdes y comandos supercrípticos.
Era lo habitual en IA local hasta hace
nada, ¿sí?
Pues aquí es donde la cosa se pone
muy interesante.
Entras a través de un panel de control
llamado TinyOS y es supervisual.
Es que democratizar el acceso es vital para
la adopción masiva y TinyOS es totalmente transparente.
Te monitoriza el rendimiento en tiempo real.
Ves la carga exacta de la NPU, la
RAM unificada, el uso de tokens histórico.
Te da una sensación de control real.
Pero el salto cualitativo de verdad está en
la Agent Store.
La tienda de aplicaciones, ¿sí?
Es una especie de tienda de apps que
convierte modelos supercomplejos en herramientas listas para usar.
Incluye desde KiloCode para programar hasta interfaces completas
de Stable Diffusion Web UI.
O sea, para generar imágenes sin instalar 50
dependencias de software, que es un dolor de
cabeza.
Exacto.
O Silly Tavern para crear conversaciones de rol
inmersivas.
Lo instalas con un clic, como en el
móvil.
Y dentro de ese ecosistema me ha volado
la cabeza la herramienta TinyBot.
Ah, la integración remota.
Sí, sí.
Inspirada en interfaces como OpenClose.
Te permite conectar tu pequeño servidor en casa
a través de un bot de Telegram o
Discord.
Eso es fascinante.
A ver, yo estoy fuera de casa, saco
el móvil, abro Telegram y le pido un
resumen de un PDF o el clima de
Melbourne a través de una API.
Y es mi propio dispositivo físico en mi
escritorio procesando eso.
Claro.
En términos prácticos, lo que tienes ahí es
tu propia infraestructura en la sombra.
Literalmente.
Es el puente perfecto entre mantener el control
absoluto y paranoico de tus datos a nivel
local y seguir teniendo la tremenda conveniencia de
la nube.
Vale.
Pasemos de la teoría a las trincheras.
Porque, sobre el papel, todo suena perfecto.
¿Qué pasa cuando realmente le exigimos tareas complejas
al cacharro?
Que salen a la luz las peculiaridades de
una tecnología emergente, como es normal.
Las fuentes detallan pruebas que te dan un
baño de realidad.
Mira la generación de imágenes con el modelo
Z -Image TuneWall.
Las anécdotas de esas pruebas son muy buenas.
Son para enmarcar.
Le piden al modelo generar la imagen, y
un gato con un sombrero.
Y el resultado devuelto es...
¿Un cuadrado rojo?
Un cuadrado plano y rojo, sí.
Un fallo de lógica total.
Un colapso absoluto.
Pero luego le piden un gato tocando la
guitarra y...
¡Pum!
Genera una imagen fotorrealista perfecta al primer intento.
A ver, es que esos saltos, entre fallo
catastrófico y éxito perfecto, muestran la naturaleza experimental
de comprimir modelos en ecosistemas tan cerrados.
Y no solo con imágenes.
Hubo un intento de programar un juego de
vuelo en 3D, usando el asistente KiloCode.
Ese caso es interesantísimo.
Tela marinera.
El programador usa el modelo GLM 4 .7
Flash y le pide que inspeccione la pantalla
del navegador para corregir errores visuales.
Y falla estrepitosamente.
Falla porque ese modelo no es multimodal.
Es ciego.
No puede ver píxeles en pantalla.
Solo texto.
Claro, el sistema no podía ver el problema
en absoluto.
Aunque, curiosamente, el código subyacente que escribió para
el terreno 3D en JavaScript fue sorprendentemente bueno
a la primera.
Es que ahí entran los datos duros de
rendimiento para dar contexto a estas anécdotas.
Porque a pesar de esos tropiezos lógicos, las
métricas son de otra liga.
Dímelas.
Si ejecutas un modelo generalista mastodóntico, como el
GPTOS de 120 .000 millones, el sistema rinde
entre 12 y 18 tokens por segundo.
Que es una velocidad de lectura superior a
la humana, ejecutándose en local y con 30
vatios.
Exacto.
Y si te vas a modelos más ligeros
y especializados en código, como Qen3C Coder de
30 .000 millones, alcanza los 25 tokens por
segundo.
No despeinarse, vamos.
Nada.
Ni mutarse.
En las pruebas fue capaz de generar una
web educativa interactiva sobre serpientes, con 710 líneas
de código continuo, incluyendo lógica, diseño visual y
animaciones.
Pues entonces, ¿qué significa todo esto al final
del día?
Porque hay que hacer de abogado del diablo.
No todo es perfecto, la física existe.
La física es la que manda.
Siempre.
Y concentrar esa potencia genera calor.
Para enfriar la NPU, el dispositivo tiene un
ventilador pensado Sí, operando a unas revoluciones altísimas.
Y las fuentes mencionan un ruido agudo constante.
Un zumbido que en un entorno silencioso de
oficina se hace notar.
Es el peaje inevitable de la miniaturización extrema,
claro.
Pero aparte del ruido, de momento el ecosistema
de software es lo que llamamos un jardín
vallado.
Ese es el gran hándicap para los usuarios
muy técnicos.
O sea, los modelos están curados por Tiny
AI.
No puedes irte alegremente a Hugging Face, descargarte
un archivo, un archivo libre estándar y ponerlo
a funcionar.
Estás limitado a lo que te dan ellos
en su tiembla.
Probablemente porque cada modelo exige un trabajo de
compilación previo para exprimir esa arquitectura dual Powering
Fair.
Tienen que ajustar muy bien qué va a
la NPU y qué va al SOC.
Claro, te cambian Rilibertad por estabilidad.
Y por último, el tema del precio, que
no es moco de pavo.
Salió a 1 .399 dólares en Kickstarter y
su precio final estimado es de casi 1
.900 dólares.
Es una inversión seria, sí.
Por ese dinero te montas un ordenador de
sobremesa tradicional bastante capaz.
¿Realmente esto lo sustituye?
A ver, sintetizando, no.
No reemplaza a un monstruo de estación de
trabajo con múltiples tarjetas gráficas gigantes.
Si vas a entrenar modelos desde cero, esto
no es para ti.
Lógico.
Pero es que abre una categoría completamente nueva.
Hablamos de IA significativa, portátil, privada y de
muy bajo consumo.
Totalmente.
Totalmente.
Lleva a un pensamiento final para dejar resonando
a quien nos escuche.
Si un despacho de abogados o un equipo
de programadores puede amortizar este hardware en un
par de meses… Porque se ahorran las suscripciones
mensuales a la nube, claro.
Exacto.
Tienen una fábrica de tokens ilimitados y confidenciales
en el bolsillo.
A largo plazo, ¿cómo de sostenible es el
modelo de negocio basado en suscripciones de los
gigantes tecnológicos de la nube?
Es la gran pregunta.
Estamos asomándonos a una posible descentralización masiva del
poder de cómputo.
Una revolución desde la mochila de cada usuario,
literalmente.
Antes de despedirnos, hasta el próximo programa os
informamos de que las voces que oyes han
sido generadas por la IA de Notebook LM
y que dirigiendo el podcast se encuentra Julio
Pablo Vázquez, un humano que te envía saludos.
En caso de error, probablemente sean errores humanos.
Nos escuchamos.
Y hasta aquí el episodio de hoy.
Muchas gracias.
Muchas gracias por tu atención.
Esto es BIMPRAXIS, nos escuchamos en el próximo
episodio.