Buenas, esto es BIMPRAXIS, el podcast donde el
Download transcript (.srt)
0:10
0:15
0:20
0:23
0:26
0:28
0:37
0:40
0:42
0:45
0:48
0:50
0:50
0:53
0:54
0:55
0:57
1:01
1:03
1:04
1:05
1:08
1:09
1:12
1:15
1:17
1:20
1:20
1:23
1:23
1:24
1:26
1:29
1:30
1:33
1:35
1:37
1:40
1:42
1:45
1:49
1:51
1:53
1:54
1:57
2:00
2:01
2:03
2:04
2:06
2:08
2:10
2:13
2:16
2:17
2:18
2:19
2:21
2:23
2:27
2:29
2:33
2:36
2:37
2:39
2:41
2:43
2:45
2:48
2:50
2:53
2:56
2:58
3:00
3:03
3:06
3:07
3:08
3:09
3:11
3:14
3:16
3:18
3:20
3:23
3:25
3:28
3:30
3:31
3:33
3:37
3:38
3:41
3:44
3:44
3:45
3:47
3:51
3:54
3:55
3:56
3:57
3:58
4:00
4:04
4:07
4:08
4:11
4:13
4:16
4:19
4:20
4:22
4:26
4:28
4:31
4:34
4:37
4:38
4:39
4:40
4:42
4:44
4:46
4:49
4:50
4:52
4:53
4:56
4:58
5:00
5:02
5:05
5:08
5:09
5:10
5:12
5:14
5:17
5:18
5:21
5:22
5:26
5:29
5:31
5:33
5:35
5:38
5:41
5:43
5:44
5:46
5:48
5:50
5:52
5:54
5:57
5:59
6:02
6:02
6:05
6:07
6:09
6:12
6:14
6:16
6:17
6:19
6:21
6:23
6:25
6:27
6:28
6:31
6:33
6:36
6:37
6:38
6:39
6:40
6:42
6:44
6:47
6:50
6:53
6:55
6:58
7:01
7:03
7:05
7:06
7:08
7:09
7:12
7:16
7:18
7:19
7:20
7:24
7:26
7:28
7:29
7:32
7:35
7:35
7:38
7:40
7:43
7:46
7:48
7:51
7:54
7:56
7:59
8:02
8:05
8:09
8:10
8:12
8:13
8:16
8:19
8:20
8:23
8:25
8:26
8:29
8:31
8:31
8:33
8:36
8:39
8:41
8:42
8:44
8:48
8:50
8:51
8:53
8:56
8:59
9:02
9:05
9:09
9:11
9:11
9:14
9:17
9:20
9:23
9:25
9:27
9:29
9:32
9:34
9:35
9:37
9:38
9:39
9:40
9:41
9:44
9:46
9:47
9:49
9:51
9:51
9:54
9:56
9:59
10:00
10:00
10:02
10:04
10:05
10:07
10:07
10:11
10:14
10:17
10:18
10:21
10:23
10:24
10:25
10:28
10:31
10:36
10:39
10:42
10:46
10:48
10:49
10:50
10:53
10:57
10:59
11:01
11:05
11:07
11:09
11:12
11:15
11:16
11:19
11:22
11:24
11:26
11:28
11:31
11:31
11:35
11:38
11:38
11:41
11:45
11:46
11:47
11:50
11:53
11:55
11:57
11:59
12:01
12:03
12:07
12:08
12:09
12:12
12:14
12:17
12:20
12:22
12:25
12:28
12:30
12:34
12:36
12:36
12:40
12:41
12:42
12:44
12:45
12:48
12:50
12:53
12:53
12:56
12:58
13:01
13:04
13:05
13:07
13:08
13:10
13:12
13:15
13:18
13:20
13:20
13:23
13:26
13:29
13:30
13:33
13:35
13:37
13:39
13:42
13:44
13:48
13:50
13:51
13:53
13:55
13:58
14:00
14:01
14:04
14:06
14:08
14:11
14:12
14:14
14:17
14:18
14:19
14:21
14:24
14:26
14:28
14:31
14:34
14:35
14:36
14:37
14:40
14:43
14:44
14:47
14:48
14:49
14:50
14:52
14:55
14:57
14:58
15:01
15:04
15:05
15:05
15:09
15:12
15:13
15:15
15:17
15:22
15:23
15:25
15:28
15:29
15:30
15:32
15:35
15:38
15:43
15:46
15:49
15:51
15:52
15:55
15:58
15:59
16:02
16:03
16:06
16:08
16:10
16:12
16:15
16:16
16:19
16:20
16:22
16:25
16:26
16:27
16:28
16:30
16:31
16:35
16:37
16:39
16:41
16:43
16:45
16:48
16:51
16:52
16:54
16:57
16:57
16:59
17:01
17:02
17:04
17:06
17:09
17:12
17:14
17:16
17:20
17:20
17:22
17:25
17:26
17:28
17:30
17:33
17:36
17:37
17:38
17:41
17:45
17:47
17:48
17:49
17:51
17:52
17:55
17:58
18:01
18:05
18:06
18:07
18:08
18:11
18:15
18:16
18:18
18:20
18:22
18:23
18:26
18:28
18:30
18:31
18:34
18:34
18:36
18:38
18:40
18:42
18:44
18:45
18:48
18:50
18:52
18:53
18:54
18:56
18:57
18:58
19:01
19:03
19:04
19:08
19:09
19:12
19:12
19:17
19:19
19:21
19:23
19:26
19:28
19:31
19:32
19:34
19:35
19:37
19:40
19:41
19:43
19:46
19:48
19:51
19:53
19:53
19:55
19:56
19:59
20:02
20:03
20:06
20:09
20:11
20:13
20:17
20:19
20:20
20:23
20:26
20:29
20:33
20:36
20:40
20:42
20:45
20:49
20:52
20:54
20:56
20:58
21:02
21:04
21:07
21:10
21:12
21:13
21:16
21:20
21:23
21:24
21:27
21:29
21:32
21:35
21:38
21:41
21:53
21:55
22:06
22:09
BIM se encuentra con la inteligencia artificial.
Exploramos la ciencia, la tecnología y el futuro
desde el enfoque de la arquitectura, ingeniería y
construcción.
¡Empezamos!
Muy buenas, bienvenidas, bienvenidos a un nuevo episodio
de BIMPRAXIS.
Hoy os traemos, acelerando la IA, cómo las
memorias caché están salvando tiempo y dinero en
la era de los modelos de lenguaje.
Hola, ¿qué tal?
Un tema absolutamente vital hoy en día, la
verdad.
Totalmente.
A ver, para ponernos en situación, imaginemos un
escenario que, bueno, se ha vuelto peligrosamente común,
diría yo, en la industria tecnológica actual.
Uf, me lo veo venir.
Sí, sí.
Fíjate, un equipo de ingeniería lanzó una aplicación,
¿vale?
Respaldada por un modelo de lenguaje generativo masivo.
La herramienta resuelve una necesidad real, a la
gente le encanta, la adopción de usuarios se
dispara, la curva de crecimiento se vuelve vertical
y...
Y de repente llega el susto de fin
de mes.
Exacto.
Llega la primera factura de la infraestructura en
la nube y son, no sé, 50.000 euros.
Así, de golpe.
Madre mía, 50.000 euros que duelen físicamente.
Duelen, duelen mucho.
Y lo más sangrante del asunto, lo que
de verdad duele a nivel de ingeniería, es
que gran parte de ese presupuesto astronómico se
ha esfumado en generar respuestas que el modelo,
en la práctica, ya había procesado y calculado
horas antes para otros usuarios.
Claro, es que es la paradoja definitiva del
desarrollo actual.
O sea, el éxito masivo puede quebrar literalmente
un proyecto por culpa de una arquitectura ineficiente.
Es que morir de éxito nunca ha sido
tan literal, ¿no?
Totalmente.
Porque, a ver, el consumo de las APIs
de inteligencia artificial no funciona como el tráfico
web tradicional.
Aquí, la latencia y el coste financiero escalan
de forma lineal y vamos despiadada con cada
token generado.
Cada palabra es dinero.
Eso es.
Y frente a esta amenaza, pues la ingeniería
de software se ha visto obligada a implementar
unas capas de optimización muy, muy sofisticadas.
Que es justo nuestra misión de hoy.
Vamos a diseccionar a nivel técnico las dos
trincheras principales de esta batalla, ¿verdad?
Exacto.
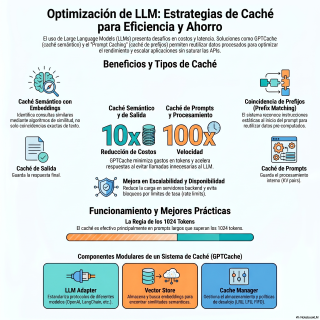
Por un lado, tenemos la caché semántica para
las respuestas finales, que la vamos a ver
a través de un proyecto de código abierto
buenísimo llamado GPT-Caché.
Mmm, interesantísimo.
Y por otro lado, el almacenamiento en caché
pero del procesamiento de entrada, o sea, los
prompts, basándonos en un análisis técnico muy revelador
de IBM Technology.
Vale, pues vamos a empezar por lo básico,
porque el instinto más fundamental de la informática
para evitar recalcular cosas siempre ha sido la
memoria caché.
¿De toda la vida vamos?
Claro.
Si una base de datos ya ha devuelto
un resultado complejo, pues ese resultado se almacena
temporalmente y listo.
Pero el problema de aplicar esta lógica, así,
tan binaria, a los modelos de lenguaje es
que la caché tradicional opera bajo un régimen
de coincidencia léxica absoluta.
O sea, que tiene que ser exactamente la
misma letra, el mismo espacio, todo.
Eso es.
Yo lo veo como el funcionamiento de un
restaurante con un protocolo, digamos, extremadamente rígido.
A ver esa analogía.
Fíjate, si la primera comanda exige una hamburguesa
con queso, pues la cocina prepara el plato,
¿vale?
Vale.
Pero si el siguiente cliente entra y solicita
una hamburguesa que lleve queso, un sistema tradicional,
una caché clásica, descartaría el trabajo previo por
completo.
Claro, porque la cadena de texto no es
idéntica.
Exactamente.
Obligaría a la cocina a empezar el proceso
de elaboración desde cero, simplemente porque la cadena
de caracteres no coincide matemáticamente, aunque el cliente
quiera lo mismo.
Es que esa variabilidad infinita de la expresión
humana es lo que destroza por completo el
índice de aciertos, lo que llamamos el hit
ratio de las arquitecturas de caché clásicas.
O sea, un clúster de Redis normal y
corriente ahí no nos sirve de mucho.
No, porque evalúa hashes de texto plano.
Te dice, no es igual y ya está.
Y para solucionar esta ineficiencia tan crítica, aquí
es donde entra GPT Caché e introduce una
capa de evaluación algorítmica previa a la búsqueda.
Vale, o sea, ¿se pone en medio?
Exacto.
Intercepta la consulta.
En lugar de comparar letras, el sistema coge
la consulta del usuario y la procesa a
través de un modelo de embedding ligero.
Vale, la convierte en vectores.
Eso es.
Este modelo transforma la frase en un vector
denso.
Digamos, una matriz de números flotantes que representa
las coordenadas semánticas de esa frase en un
espacio multidimensional.
Suena a ciencia ficción, pero básicamente es que
el sistema deja de buscar palabras exactas y
empieza a calcular distancias matemáticas, ¿no?
El significado de fondo.
Totalmente.
Entiende el significado.
Si dos frases apuntan al mismo sitio en
ese espacio multidimensional, es que significan lo mismo.
Ya, claro.
Pero a ver, la conversión a vectores altera
las reglas del juego, sí.
Pero calcular esas distancias matemáticas entre cientos de
miles de registros en tiempo real, a mí
me suscita dudas sobre el rendimiento.
Es una duda superlógica.
Claro, porque si el objetivo primordial es reducir
la latencia, introducir un modelo intermedio que se
ponga a evaluar coordenadas suena a un proceso
que, no sé, podría generar su propio cuello
de botella.
Ya, parece contraproducente, ¿verdad?
Un poco, sí.
¿Cuál es el mecanismo exacto que permite que
esta evaluación no penalice el tiempo de respuesta
final y acabemos peor de lo que empezamos?
Pues la clave reside en la optimización bestial
de las bases de datos vectoriales y en
una métrica matemática que es la similitud de
cosenos.
El sistema no escanea toda la base de
datos de principio a fin, secuencialmente.
Eso sí que sería lento.
Emplea algoritmos de búsqueda aproximada de vecinos más
cercanos.
Digamos que estructuran el espacio vectorial en grafos
navegables.
Cuando la nueva consulta entra ya convertida en
un vector, el sistema calcula el ángulo entre
ese vector y los que ya tiene almacenados.
O sea, si el ángulo es muy cerrado,
es que está muy cerca, ¿no?
Exacto.
Un ángulo cerrado indica una altísima similitud semántica.
Y lo alucinante es que esta operación matemática
en arquitecturas especializadas ocurre en la escala de
los milisegundos.
¡Guau!
¡Milisegundos!
Sí, sí.
Si lo comparas con el proceso autoregresivo de
un modelo de lenguaje masivo, que, oye, tiene
que inferir, generar y proyectar las probabilidades del
siguiente token uno a uno, iterativamente… Claro, la
búsqueda vectorial le da mil vueltas en velocidad.
Órdenes de magnitud más veloz.
De hecho, los datos de implementación de GPT-Caché
reflejan una reducción de los costes operativos de
hasta 10 veces.
10 veces menos coste.
Y mejorando la velocidad de respuesta por un
factor de 100 en algunos casos.
Madre mía.
Pero claro, un salto de rendimiento de esa
magnitud requiere una monitorización exhaustiva.
Desplegar una capa semántica no es darle un
botón y olvidarse.
¿Qué va?
El mantenimiento exige vigilar métricas fundamentales para garantizar
que la caché no se vuelva loca y
esté devolviendo resultados imprecisos.
Claro.
Entiendo que el hit ratio, el porcentaje de
aciertos, marca la pauta de la rentabilidad financiera,
¿no?
Es decir, ¿qué porcentaje del tráfico nos estamos
comiendo sin tocar la API de pago?
Exacto, eso es el dinero que te ahorras
Y luego tienes la latencia, que básicamente te
confirma la mejora en la experiencia del usuario,
que la app va fluida Vale, pero hay
una tercera métrica, el recall, que me parece
la más delicada en un entorno así, tan
probabilístico Es que el recall lo es todo
para la robustez del sistema, fíjate Básicamente evalúa
la proporción de consultas que la Cachea atendió
correctamente Sobre el total de consultas que legítimamente
debería haber interceptado interceptado.
O sea, los aciertos reales.
Eso es.
Mira, si el umbral de similitud matemática lo
configuras de manera demasiado restrictiva, en plan tienen
que ser casi idénticas.
Pues el hit ratio se desploma y volvemos
a gastar recursos tontamente, claro.
Exacto.
Pero si el umbral es excesivamente laxo y
dejas pasar cualquier cosa que se parezca un
poco.
Uf, peligro.
Claro, el sistema pecará de falsos positivos.
Imagínate, entregando una respuesta sobre cómo hacer una
factura a un usuario que en realidad preguntaba
por reembolsos.
Un desastre para la experiencia del usuario.
O sea, calibrar esa sensibilidad es el núcleo
de la ingeniería de la caché semántica, por
lo que veo.
Es el arte detrás de todo esto totalmente.
Y al trasladar esa calibración a una infraestructura
de producción real, supongo que la flexibilidad de
la herramienta se vuelve crítica, porque a menudo
adoptar nuevas capas de optimización conlleva el riesgo
de quedarte atrapado en un ecosistema propietario.
El temido vendor locking, sí.
Eso es.
Si mi equipo ya ha diseñado su arquitectura
usando, no sé, llama.cpp para ejecutar inferencia en
local o depende de modelos muy específicos en
la nube, pues que me impongan un adaptador
único suele ser motivo de descarte inmediato.
Y con razón.
Pero precisamente por ello, la arquitectura de GPTKH
se ha diseñado bajo un paradigma estrictamente modular.
No es un bloque monolítico.
Vale, me gusta eso.
Es un poco como montar un ordenador a
piezas, ¿no?
Un PC custom.
Justo.
Es una analogía perfecta.
El sistema desacopla totalmente la lógica del almacenamiento
de la interfaz del modelo.
Tú eliges las piezas.
O sea, yo elijo mi tarjeta gráfica, que
sería el LLM.
Exacto.
El módulo del adaptador de LLM te permite
rutear las peticiones hacia la API de OpenAI,
hacia implementaciones de launching o entornos locales sin
ninguna fricción.
Qué bueno.
Y ojo que no solo hay texto.
Tienen un adaptador multimodal.
¿Multimodal?
Para imágenes y audio.
Sí, sí.
Operaciones masivamente pesadas como la síntesis de imágenes
en Stable Diffusion o transcripciones de audio larguísimas
con Whisper, todo eso puede beneficiarse de la
misma retención semántica.
Claro, te evitas regenerar exactamente el mismo activo
multimedia si la petición es análoga.
Es un ahorro brutal.
Brutal.
Pero volviendo a la analogía del PC, ese
nivel de modularidad requiere tomar decisiones sobre el
hardware, sobre dónde residen físicamente esos datos.
Veo que la arquitectura separa claramente el lugar
donde se guardan los vectores, el vector store,
del lugar donde reside la respuesta cruda, el
texto final, que sería el Caché storage, o
sea, el disco duro.
Exactamente.
Herramientas como Faiz o Milbus se encargan de
toda esa matemática vectorial rápida, mientras que bases
de datos transaccionales de toda la vida, como
Postgres, custodian los textos de salida.
Pero claro, esta separación plantea el ineludible problema
de la saturación bajo carga masiva, porque la
memoria RAM es la que es, es un
recurso finito y bastante costoso, por cierto.
Ya te digo, la degradación del rendimiento por
saturación de memoria.
Los famosos errores OOM, Out of Memory.
Las pesadillas de los de sistemas.
Es el punto de fallo más habitual en
implementaciones ingenuas, fíjate.
Si la aplicación experimenta un pico de tráfico
por un evento externo, oye, la caché crecerá
a un ritmo exponencial.
Y depender exclusivamente de la memoria local de
un único servidor te garantiza un colapso.
Matemático.
Por eso, gestionar el ciclo de vida de
los datos exige implementar políticas de expulsión agresivas.
O sea, tirar cosas a la basura.
Claro.
El algoritmo LRU, por ejemplo, que descarta los
elementos que llevan más tiempo sin ser consultados,
es súper efectivo en apps de cara al
público, donde el tráfico suele ir por modas
o temas de actualidad.
Ya, lo viejo se borra.
Y supongo que, para evitar la redundancia y
asegurar alta disponibilidad, pues la arquitectura debe escalar
horizontalmente.
Sí o sí.
Desplegar una Caché distribuida apoyándose en sistemas probados
como Memcached o Redis.
O sea, que todo un clúster de servidores
comparta un único cerebro, un estado único.
Si un servidor en Europa calcula y guarda
una respuesta muy compleja, cualquier otro nodo, a
nivel global, en Asia o América, hereda ese
acceso instantáneamente.
Neutralizando la necesidad de duplicar el esfuerzo y
protegiendo la memoria de cada máquina.
Brillante.
Es una infraestructura que resuelve magistralmente la redundancia
en las respuestas finales.
Pero.
Ah, amigo, siempre hay un pero.
Siempre.
Porque todo esto de GPT-Caché es genial si
los usuarios hacen preguntas parecidas.
Pero, ¿qué pasa si cambiamos las reglas?
A ver.
Analicemos el escenario del RAG, el Retrieval Augmented
Generation.
En estos sistemas, inyectamos documentos masivos, a veces
decenas de miles de palabras, en la ventana
de contexto de la IA.
Sí, para fundamentar la respuesta y que no
alucine.
Exacto.
Pues imagínate que un usuario le mete a
la IA un manual técnico de 100 páginas
y le hace una pregunta súper específica sobre
el capítulo 3.
Vale.
Y 10 minutos después, el mismo usuario u
otro, con el mismo manual, le hace una
pregunta completamente diferente sobre el glosario final.
Claro.
La caché semántica de resultados aquí falla estrepitosamente
porque las respuestas que tiene que dar la
IA deben ser distintas.
Sí, sí, irremediablemente.
Porque las salidas esperadas son divergentes.
Entonces la perspectiva cambia por completo.
Ya no buscamos reciclar el plato ya cocinado.
Buscamos otra cosa, que es lo que explica
la documentación de IBM, ¿no?
El prompt caching.
Eso es, el almacenamiento en caché de entradas.
Que yo lo asocio mucho con la mise
en place, en la alta gastronomía.
Me encanta, explícalo.
Pues a ver, si la caché semántica era
una nevela donde guardabas el plato ya terminado
y solo lo calentabas.
El prompt caching es todo el trabajo preparatorio
de la cocina.
El equipo ya ha picado la cebolla, ha
hecho los caldos, tiene las salsas listas… Todo
organizado.
Exacto.
Si entra una comanda de un plato diferente
pero que usa esa base, esos mismos caldos,
te ahorras el 90% del trabajo pesado.
Es que el concepto de la mise en
place captura literalmente la esencia de la fase
de prellenado o el pre-fill en la arquitectura
de los transformers.
A ver, explícanos un poco las tripas de
eso.
Pues para entender el ahorro hay que visualizar
el mecanismo interno del LLM.
Cuando ese manual de 100 páginas entra al
sistema, el modelo no empieza a escribir texto
de inmediato.
No es magia, claro.
Para nada.
Los mecanismos de atención de la red neuronal
tienen que calcular la relación de cada token
con todos y cada uno de los tokens
precedentes.
O sea, entender el contexto de la palabra
tornillo en la página 50 respecto a la
página 2.
Eso es.
Y ese proceso requiere computar unas matrices gigantescas
que se conocen como pares clave-valor, los KV
pairs.
Y supongo que esa computación se adentra en
el territorio de la complejidad cuadrática, ¿no?
Porque si evaluamos 50.000 tokens simultáneamente… Las matemáticas
se disparan.
El número de operaciones de multiplicación de matrices
que la GPU tiene que comerse alcanza cifras
astronómicas.
Madre mía.
Y ojo, que esto se repite en cada
una de las capas ocultas del transformer.
El desgaste de ciclos de procesamiento es absoluto.
Y, claro, como los modelos por defecto no
tienen memoria de estado, si le mandas la
segunda pregunta con el mismo manual adjunto, la
IA desecha todo lo de antes.
Todo a la basura.
Inicia el cómputo masivo de los pares clave-valor
desde la primera letra del manual.
¡Qué ineficiencia!
Entonces el prompt caching interviene ahí.
Exacto.
Interceptando y guardando estas matrices de atención en
la memoria VRAM a altísima velocidad de la
GPU.
Al detectar que un bloque de texto coincide
con uno recién procesado, el sistema carga ese
estado precalculado.
Ah, o sea, recupera el contexto ya en
formato matemático.
Y así solo se esfuerza en calcular los
tokens nuevos, es decir, la preguntita nueva del
usuario.
Eso es.
Pura eficiencia.
El impacto en la latencia tiene que ser
brutal, claro.
pero exija una precisión, digamos, quirúrgica.
El sistema tiene que saber rapidísimo qué parte
recicla y qué parte es nueva.
Sí, y aquí es donde las reglas del
juego se ponen estrictas.
Para discriminar esto, se usa la técnica de
coincidencia de prefijos, el prefix matching.
Que evalúa de izquierda a derecha, entiendo.
Estrictamente secuencial.
Construye como una estructura de árbol.
El motor recorre la instrucción nueva token a
token.
Mientras todo sea idéntico a lo que hay
en caché, recicla los pares KV.
Vale.
Pero la severidad de esto es que, en
el instante en que detecta un solo token
distinto, un carácter, un espacio extra, un salto
de línea cambiado, se rompe la magia.
Se rompe de forma irreversible.
Desde ese punto de divergencia hacia adelante, te
obliga a ejecutar el cómputo completo otra vez.
¡Guau!
O sea que esta rigidez obliga a los
desarrolladores a replantear la ingeniería de los prompts
desde los cimientos.
Totalmente.
Ya no es cómo escribes para que suene
bonito, es que la sintaxis determina la rentabilidad
financiera de tu empresa.
Es que hay una regla de oro aquí,
¿no?
La información debe organizarse en un gradiente estricto,
de lo más estático a lo más dinámico.
Eso es fundamental que la audiencia se lo
grave a fuego.
Sí, sí.
O sea, lo que no cambia, arriba del
todo.
La arquitectura óptima exige que consolides todos los
bloques invariables en la cabecera.
Instrucciones del sistema, en plan, eres un asistente
útil, el contexto kilométrico del manual, los ejemplos
estáticos.
Todo eso primero.
En los primeros estratos.
Y la consulta específica y efímera del usuario,
la pregunta, debe ir estrictamente confinada al final
del documento.
Porque si inviertes el orden, catástrofe.
Si un desarrollador pone la pregunta del usuario
en la primera línea y luego le pega
el manual de 100 páginas.
Pues que el primer token generado por cada
usuario va a ser diferente siempre.
Y el prefix matching falla en el milisegundo
1.
Invalidas la posibilidad de recuperar el bloque gigante
que va detrás.
Exacto.
Un simple error de concatenar strings en el
código y te has cargado la eficiencia de
toda la infraestructura.
Apagar el cálculo estático en cada petición.
¡Qué locura!
Pero, viendo lo elegante que es esta solución,
a mí me surge una duda.
¿Por qué no guardamos en caché el contexto
de absolutamente todo?
A ver, explícate.
Pues si un usuario le dice hola a
un bot.
Tres palabras.
La intuición me dice que guardar esos pares
KB también sería optimizar.
Todo suma, ¿no?
Ya, pero en sistemas distribuidos ninguna abstracción te
sale gratis.
Claro, el sobrecoste de gestionar la propia caché.
Exacto.
Indexar, almacenar en memoria compartida, buscar y transferir
las matrices a la GPU.
Todo eso añade latencia y coste.
O sea, hay un umbral de rentabilidad.
Sí, los proveedores principales suelen establecer la barrera
en unos 1024 tokens de entrada.
Para secuencias más cortas que eso, tardas más
en buscar en la caché que en dejar
que el modelo lo procese en bruto.
Tiene sentido.
Y me imagino que esta mise en place
digital es efímera, no dura para siempre.
Para nada.
Para no saturar el hardware, operan con políticas
de expiración súper agresivas, purgando todo tras 5
o 10 minutos de inactividad.
O sea, optimizan sesiones densas y rápidas, no
un histórico a largo plazo.
Exacto.
Al final, la lógica de la alta cocina
prevalece.
Cuando el servicio acaba, el chef ordena limpiar
la estación, tira los ingredientes preparados y recupera
el control de su encimera.
Es una analogía brillante, sí.
Encapsula perfectamente el ciclo de vida del procesamiento
en redes neuronales.
Y fíjate, contemplar esta evolución hacia la retención
semántica y estructural a mí me empuja hacia
una reflexión mucho más profunda.
A ver, cuéntame.
Pues sobre la naturaleza futura de estos sistemas.
Porque si las arquitecturas siguen perfeccionando esto, guardando
contexto de entrada y semántica de salida, nos
acercamos a un horizonte de hipereficiencia muy bestia.
Y cabe plantearse si los grandes modelos masivos
van a ir reduciendo progresivamente su, digamos, generación
estocástica real.
Se acabarán operando, en la práctica, como gigantescos
repositorios indexados que simplemente actúan como bibliotecarios.
Recuperando pensamientos precalculados del pasado.
A la velocidad de la luz, para el
99% de nuestras interacciones cotidianas.
¡Qué barbaridad!
Resulta fascinante reconsiderar así la generación del lenguaje.
Lo que desde fuera parece, no sé, una
IA, pensando en tiempo real, bajo el capó
se transforma en una labor monumental de recuperación
de estados almacenados.
Exacto.
Una coreografía compleja donde la verdadera magia reside
en evitar pensar la misma idea dos veces.
Es una perspectiva reveladora sobre la eficiencia matemática
de esta revolución.
Antes de despedirnos, hasta el próximo programa, os
informamos de que las voces que oyes han
sido generadas por la IA de Notebook LM
y que dirigiendo el podcast se encuentra Julio
Pablo Vázquez, un humano que te envía saludos.
En caso de error, probablemente sean errores humanos.
¡Nos escuchamos!
Y hasta aquí el episodio de hoy.
Muchas gracias por tu atención.
Esto es BIMPRAXIS.
Nos escuchamos en el próximo episodio.