Buenas, esto es BIMPRAXIS, el podcast donde el BIM se encuentra con la inteligencia artificial.
Download transcript (.srt)
0:09
0:20
0:28
0:37
0:41
0:46
0:49
0:53
0:58
1:01
1:07
1:09
1:10
1:14
1:16
1:22
1:26
1:28
1:33
1:37
1:39
1:41
1:46
1:48
1:49
1:51
1:53
1:56
2:02
2:04
2:05
2:08
2:12
2:13
2:15
2:16
2:20
2:22
2:23
2:24
2:29
2:31
2:32
2:35
2:38
2:39
2:40
2:44
2:45
2:49
2:53
2:56
2:57
3:01
3:06
3:08
3:10
3:13
3:16
3:19
3:20
3:21
3:27
3:28
3:31
3:33
3:34
3:41
3:44
3:49
3:50
3:55
3:56
4:01
4:04
4:06
4:07
4:08
4:10
4:15
4:22
4:25
4:26
4:28
4:35
4:37
4:38
4:39
4:46
4:49
4:50
4:53
5:00
5:01
5:02
5:04
5:06
5:08
5:11
5:14
5:17
5:20
5:26
5:28
5:33
5:37
5:41
5:43
5:44
5:52
5:53
5:58
6:01
6:05
6:06
6:09
6:16
6:17
6:19
6:21
6:22
6:24
6:31
6:34
6:37
6:38
6:42
6:50
6:52
6:56
6:58
7:03
7:04
7:08
7:17
7:18
7:20
7:24
7:27
7:30
7:32
7:34
7:35
7:36
7:43
7:45
7:55
7:57
8:02
8:04
8:12
8:19
8:20
8:21
8:23
8:28
8:30
8:32
8:37
8:38
8:41
8:43
8:44
8:46
8:49
8:51
8:56
8:57
8:59
9:04
9:05
9:06
9:09
9:12
9:18
9:21
9:22
9:26
9:28
9:34
9:36
9:37
9:40
9:46
9:48
9:52
9:55
9:57
9:59
10:07
10:10
10:11
10:16
10:21
10:27
10:28
10:32
10:36
10:38
10:46
10:52
10:56
10:58
11:01
11:04
11:10
11:17
11:23
11:26
11:30
11:33
11:39
11:46
11:49
11:55
11:57
12:05
12:12
12:19
12:22
12:25
12:29
12:34
12:36
12:43
12:48
12:53
12:59
13:05
13:09
13:14
13:20
13:25
13:30
13:36
13:38
13:47
13:50
13:55
14:00
14:05
14:20
Exploramos la ciencia, la tecnología y el futuro desde el enfoque de la arquitectura, ingeniería y construcción.
¡Empezamos!
Bienvenidas y bienvenidos a un nuevo análisis.
Hoy es un día especial porque llegamos al número 18 de la serie que BIMPRAXIS dedica a
los papers que cambiaron la historia de la IA.
Y bueno, con este nos adentramos en territorio casi desconocido.
Creo que es la primera vez que analizamos un artículo del futuro.
Es que es increíble. Lo estaba mirando antes de empezar.
El artículo principal que vamos a desgranar hoy tiene fecha de publicación de julio de 2025.
Estamos a meses de distancia.
Ya, ya.
Nos estamos acercando peligrosamente al final de la serie, ¿no es así?
Peligrosamente es la palabra.
La historia, o en este caso el futuro, nos está pisando los talones, literalmente.
Normalmente miramos al pasado, pero es que hoy el presente casi nos ha alcanzado.
La historia nos atropella.
Pues precisamente por eso, porque la escala de la IA avanza a esta velocidad de vértigo,
hoy nos sumergimos en un concepto clave para poder manejarla.
La destilación de conocimiento.
Un término que es una casi alquimia, ¿verdad?
Pero que es fundamental para que la IA no sea solo cosa de superordenación,
sino algo que podamos llevar en el bolsillo.
Exacto.
Nuestra misión de hoy.
Entender qué es eso de destilar conocimiento,
por qué es vital para los gigantescos modelos de lenguaje actuales,
y cómo esta técnica del futuro cercano propone hacerlo de una forma radicalmente más eficiente.
Y para eso tenemos dos fuentes, ¿no?
Sí.
Contamos con un artículo general que nos va a dar las bases,
y el ya mencionado paper de 2025 que nos mostrará la vanguardia absoluta.
Rimbombante.
Es sorprendentemente intuitiva.
¿Verdad?
Se basa en una de las formas de aprendizaje más antiguas que existen.
¿La del maestro y del aprendiz?
Justo.
Vale, me gusta por dónde vas.
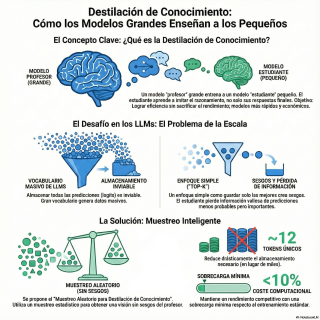
Imaginemos un modelo de IA enorme, potentísimo, que ha costado millones entrenar.
Ese sería nuestro profesor.
Eso es.
Y luego tenemos un modelo mucho más pequeño, ágil,
que queremos que sea igual de listo, pero sin tanto coste.
Nuestro alumno.
Exacto.
El objetivo no es que el alumno se aprenda de memoria las respuestas del profesor.
El objetivo es que el profesor aprenda de memoria las respuestas del profesor.
El objetivo es que el profesor le enseñe su forma de pensar, su intuición.
Me viene a la mente la analogía del chef que usan las fuentes.
Un chef experto no sólo le da la receta a su aprendiz.
No, claro.
Le enseña a oler los ingredientes, a sentir la textura de la masa.
Le explica por qué añade una pizca de sal justo en ese momento y no en otro.
Le transmite el porqué de las cosas.
Has dado en el clavo.
Y esa transmisión de la intuición es la clave.
Porque el motivo para hacer esto es la pura y dura eficiencia.
Los modelos grandes son carísimos.
Carísimos y lentos.
Muy lentos.
Me recuerda cuando usas una de esas apps de IA en el móvil que tardan una eternidad en generar una imagen.
Totalmente.
Supongo que la destilación intenta solucionar eso a gran escala, ¿no?
Poder tener esa potencia sin la espera.
Exacto.
La destilación permite crear modelos más pequeños que se pueden ejecutar en hardware menos potente, como un teléfono,
pero conservando gran parte de la sabiduría del modelo grande.
Y aquí es importante la distinción que hacen las fuentes, que no es simplemente compresión de modelos.
No, no lo es.
No estamos cogiendo el modelo grande y comprimiéndolo como si fuera un archivo zip.
Para nada.
Estamos entrenando un modelo completamente nuevo y distinto para que aprenda del grande.
Es un proceso de enseñanza, no de compresión.
Es una diferencia fundamental.
Vale.
La idea está clara.
Pero aquí viene la pregunta del Millén.
¿Cómo se transfiere algo tan etéreo como la intuición de una máquina a otra?
Pues aquí es donde el paper de Hinton de 2015, que es la referencia clave en este campo, dio un golpe de genialidad.
El truco está en lo que llaman las salidas suaves.
¿Salidas suaves?
A ver, explícame eso.
Un modelo normal, si le enseño la foto de mi perro, me dirá con un 99% de seguridad, esto es un perro.
Una respuesta dura.
Exacto.
Pero el modelo profesor no es así.
El modelo profesor, aplicando un truco matemático llamado temperatura, puede dar una respuesta con muchos más matices.
En lugar de esa certeza casi absoluta, podría decir…
Algo como…
Estoy un 70% seguro de que es un perro.
Pero ojo, porque tiene un 20% de rasgos que me recuerdan a un lobo y quizá un 10% que podrían ser de un zorro.
Ah, vale.
Ya lo veo.
No solo le da la respuesta correcta.
Le está diciendo al alumno…
Mira, la respuesta es perro.
Pero que sepas que lobo y zorro son conceptos relacionados.
Son posibilidades remotas, pero no absurdas.
Le está dando todo un mapa de relaciones semánticas.
Y ese mapa es oro puro para el aprendizaje.
El alumno no solo aprende la etiqueta correcta, sino que absorbe la capacidad de generalización del profesor.
Aprende las sutilezas.
O sea, el objetivo no es que memorice la respuesta, sino que aprenda el razonamiento del profesor.
Su razonamiento, incluidas sus dudas, por así decirlo.
Aprende que cosas son similares, aunque no sean la respuesta correcta.
Y eso es lo que le da la verdadera flexibilidad.
Fascinante.
Y aunque suene a algo muy de ahora, las fuentes nos recuerdan que la idea de hacer las redes neuronales más eficientes viene de muy lejos.
Sí.
Los primeros intentos, dicen, son de los años 60, con técnicas de poda, de redes.
La analogía era la de un jardinero, ¿no?
Entranabas una red y luego podabas las conexiones menos útiles.
Eso es.
Y de la jardinería, pasamos a la neurocirugía.
Porque en 1989, Jan LeCun, uno de los grandes, propuso un algoritmo con un nombre que es sencillamente genial.
Optimal Brain Damage.
Daño cerebral óptimo.
Un nombre espectacular.
Totalmente.
Y la idea era muy elegante.
En lugar de podar al azar, el algoritmo identificaba matemáticamente las conexiones menos importantes y las eliminaba.
Como un cirujano que extirpa tejido no esencial.
Y de ahí, el siguiente salto conceptual fue crucial.
Sí.
Si conectamos esto con el panorama general, vemos un cambio de paradigma.
En los años 90, gente como Jürgen Schmidhuber ya estaba trabajando con configuraciones de redes profesor-alumno.
Se pasó de arreglar una red a…
A usar activamente una red para enseñar a otra desde cero.
Ahí está el cambio de mentalidad.
No es optimizar lo que tienes, es usarlo para crear algo nuevo y mejor adaptado.
Correcto.
El término compresión de modelos ya se usó en 2006.
Pero fue el paper de Geoffrey Hinton y su equipo en 2015 el que realmente popularizó y formalizó lo que hoy llamamos destilación de conocimiento.
Muy bien.
La historia nos deja en 2015.
Pero ahora estamos en la era de los GPT-4 y compañía.
¿Qué significa todo esto para los gigantescos modelos de lenguaje?
Y aquí entra nuestro paper de 2025.
Aquí es donde el problema, como siempre…
Es la escala.
Una escala que marea.
Totalmente.
El vocabulario de un gran modelo de lenguaje puede tener decenas de miles de palabras.
A veces, cientos de miles.
Recordar esa respuesta suave del profesor para cada una de esas cien mil palabras, para cada ejemplo, es computacionalmente inviable.
Es un cuello de botella.
Tienes una idea genial, pero no la puedes aplicar donde más la necesitas porque es demasiado cara.
¿Cómo se intentó solucionar esto?
Pues el enfoque más obvio, que el propio paper llama ingenuo, es quedarse solo con las probabilidades más altas, el llamado Top K.
A ver, o sea, en lugar de mirar las cien mil palabras, te quedas solo con, digamos, las cincuenta más probables.
Exacto.
Parece lógico, ¿no?
Parece una buena aproximación.
Pero los autores, Anshman y su equipo, demuestran que esto tiene dos problemas muy graves.
El primero es que crea una estimación sesgada.
Y eso lleva a una mala calibración.
Murento, ¿quieres decir que el modelo se vuelve demasiado seguro de sí mismo?
Sí.
Yo pensaba que la confianza en la respuesta era algo bueno.
¿Por qué es un problema?
Es una pregunta excelente.
Porque es contraintuitivo.
El problema es que el modelo pierde la capacidad de dudar.
Se vuelve un sabelotodo.
Te dice, estoy cien por ciento seguro cuando su confianza real debería ser del sesenta.
Ya.
Y esa sobreconfianza es peligrosísima.
Imagina un modelo de diagnóstico médico que está ciegamente seguro de un diagnóstico erróneo.
Vale.
Entendido.
Es un exceso de confianza tóxico.
¿Y cuál era el segundo problema del método TOPK?
El segundo problema es que se pierde información crucial de lo que llaman la cola de la distribución.
Te refieres a las palabras con probabilidad bajísima.
Justo.
Esas miles de palabras que parecen basurar individualmente no valen nada.
Pero en conjunto contienen señales de aprendizaje.
Tienen señales de aprendizaje valiosísimas sobre lo que el modelo considera imposible o muy improbable.
¿Es como aprender tan bien lo que no se debe hacer?
Exacto.
Y si tiras esa información, el aprendizaje se empobrece.
El dilema era, o un aprendizaje pobre y sesgado, o un coste inasumible.
Parecía un callejón sin salida.
Y es justo ahí donde los autores proponen su solución, que parece casi mágica.
Radon Sampling Knowledge Distillation.
Destilación por muestreo aleatorio.
La analogía que usan es brillante.
El método TOPK es como intentar entender la opinión de un país escuchando solo a las 50 personas que más gritan en una manifestación.
Tendrás una visión muy intensa, pero completamente sesgada.
Totalmente.
Mientras que lo que ellos proponen es el equivalente a una encuesta electoral rigurosa.
En lugar de los más ruidosos, toman una muestra aleatoria pero estadísticamente representativa.
Y con unas pocas entrevistas bien elegidas, obtienes una idea muy precisa de lo que opina toda la multitud.
Justo.
Pasas de un sondeo de opinión sesgado a uno científicamente robusto.
Y la base matemática de esto es el muestreo por importancia.
¿Y cómo funciona? A grandes rasgos.
Pues, a ver, es una técnica que permite obtener una estimación sin sesgos de una distribución completa usando muy, muy pocas muestras.
El resultado es que el alumno aprende de una forma mucho más fiel al razonamiento completo del profesor.
Capturando tanto las respuestas probables como la información de la cola larga.
Exactamente.
Necesitar miles de tokens a necesitar solo una docena de muestras.
¿Doce tokens? Es una locura.
Es que, para que nos hagamos una idea, es como intentar entender la opinión de un país encuestando solo a doce personas,
pero elegidas de una forma tan inteligente que el resultado es casi perfecto. Eso es lo que lo hace viable.
Y todo esto, dicen, con un coste computacional mínimo. Menos de un 10% de tiempo extra.
Esto es lo que, por primera vez, hace que la destilación sea más fácil.
Y que la solución para el preentrenamiento de LLMs sea una opción realista.
Y los resultados de su evaluación lo confirman.
El método no solo es eficiente, sino que mejora la calibración del modelo alumno, evitando esa sobreconfianza.
Y funciona en modelos de distintos tamaños, de 300 millones a 3.000 millones de parámetros.
Entonces, si lo resumimos, me quedo con dos ideas.
La primera, que enseñar a una IA no es solo darle las respuestas correctas, sino enseñarle a dudar correctamente.
Me gusta esa forma de verlo.
Y la segunda, que gracias a métodos como este, ahora podemos hacerlo de forma tan eficiente que podría cambiar el modelo económico del desarrollo de IA.
Totalmente. Podríamos pasar de un mundo donde todos intentan construir profesores gigantes y carísimos,
a un mundo con unos pocos profesores fundacionales y millones de alumnos baratos, eficientes e hiperespecializados.
Y el impacto de esto en el día a día puede ser enorme.
Sin duda. Esta investigación es una pieza clara.
Una pieza clave para la democratización real de la IA.
Permite empaquetar la potencia de modelos gigantescos en formatos mucho más pequeños.
Para que funcionen en nuestros dispositivos.
Exacto. En un teléfono, en un portátil, abriendo la puerta a traductores en tiempo real realmente potentes en tu móvil,
o a herramientas de diagnóstico sofisticadas en clínicas rurales sin conexión a la nube.
Antes de terminar, tenemos un pequeño anuncio sobre nuestra programación.
Como hemos notado, la complejidad de estos temas que tratamos requiere un análisis cada vez más profundo.
Y para mantener la alta calidad que nos exigimos en cada entrega, pues hemos decidido ajustar nuestro calendario.
Sencillamente, necesitamos más tiempo para investigar y preparar cada análisis a fondo.
Por eso, a partir de la próxima semana, dejaremos de tener una frecuencia diaria.
Publicaremos tres análisis por semana. Los lunes, los miércoles y los viernes.
Esperamos que este nuevo ritmo nos permita ofrecerles un contenido aún mejor y más pulido.
Y ahora sí, para despedirnos, dejamos una reflexión que sale del paper de hoy.
El artículo se centra en hacer eficiente al modelo alumno. Pero esto plantea una pregunta interesante.
A ver.
Si nos volvemos extremadamente buenos destilando conocimiento, ¿podría el futuro de la IA centrarse menos en construir profesores cada vez más grandes
y más en crear incontables alumnos hiperspecializados?
¿Todos destilados a partir de un único y colosal modelo fundacional?
¿Cómo sería un mundo con un solo gran profesor y millones de alumnos expertos en tareas concretas?
Ahí queda la pregunta. Gracias por acompañarnos en este análisis.
Y hasta aquí el episodio de hoy. Muchas gracias por tu atención.
Esto es BIMPRAXIS. Nos escuchamos en el próximo episodio.